Jump to Python · · 8 min read
1. 파이썬 프로그래밍의 기초, 자료형
1. 숫자형
- 숫자 형태로 이루어진 자료형
- 정수, 실수, 복소수, 8진수, 16진수 등
- 숫자형을 활용하기 위한 연산자
- 더하기, 빼기, 곱하기, 나누기, 나머지 연산
- 제곱을 나타내는 연산자 :
a**b - 나눗셈 후 소수점 아랫자리를 버리는 연산자 :
7//4
2. 문자열 자료형
문자, 단어 등으로 구성된 문자들의 집합
- 아래와 같이 선언이 가능하다.
a = 'abc'
b = "abc"
c = """abc"""   # 여러 줄을 한번에 쓸 수 있다.
d = '''abc'''   # 여러 줄을 한번에 쓸 수 있다.
문자열 안에 작은 따옴표를 포함시킬 때 : 큰 따옴표(")로 묶는다.
문자열 안에 큰 따옴표를 포함시킬 때 : 작은 따옴표(")로 묶는다.
백슬래쉬(\)를 사용해서 강제로 일반 문자로 인식시킬 수 있다.
이스케이프 코드

문자열 연산
- 문자열 더해서 연결하기
a = "this" b = "is python" print(a + b)- 문자열 곱하기
a = "hi!"
print(a * 3)
문자열 인덱싱과 슬라이스
- 인덱싱 : 저장한 문자열의 각 문자마다 번호를 매긴다.
s = "Life is too short, You need Python" print(a[0]) # 0 인덱스는 첫번째 인덱스를 가리킨다. print(a[-1]) # -1 인덱스는 마지막 인덱스를 가리킨다.- 슬라이스 : 시작과 끝을 정하여 받아 올 수 있다.
s = "Life is too short, You need Python"
print(s[0:4]);  # 0 인덱스부터 3 인덱스까지 4개를 선택적으로 뽑는다.
print(s[:4]);   # 첫 인덱스부터 3 인덱스까지 선택적으로 뽑는다.
print(s[4:10])  # 4 인덱스부터 9 인덱스까지 선택적으로 뽑는다.
print(s[4:])    # 4 인덱스부터 마지막 인덱스까지 선택적으로 뽑는다.
print(s[:])     # 모든 인덱스를 뽑는다.
문자열 포매팅
- 숫자 바로 대입
a = 150
b = 20
print("a is %d, and b is %d" % (a, b))
문자열 포맷 코드
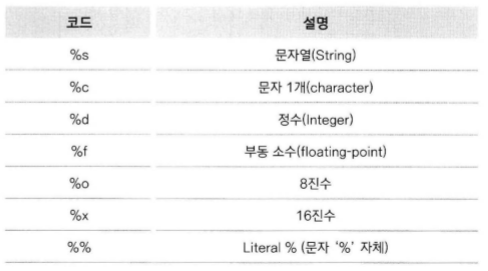
정렬과 공백
s = "hi" print("%10s" % s) # 10개의 칸을 주고 오른쪽 정렬 print("%-10stest" % s) # 10개의 칸을 주고 왼쪽 정렬- 소수점 표현하기
print("%10.4f" % 3.412321414123) # 10개의 칸을 주고 소수점 아래는 4자리만 포함하고 오른쪽 정렬한다.
문자열 관련 함수
- 문자 개수 세기(count)
s = "hobby" print(s.count('b'))- 위치 알려주기1(find)
s = "Python is best choice" print(s.find('b')) # b가 처음 나온 위치, 문자가 존재하지 않는다면 -1- 위치 알려주기2(index)
s = "Life is too short" print(s.index('b')) # b가 처음 나온 위치, 문자가 존재하지 않는다면 에러- 문자열 삽입(join)
s = ',' print(s.join('abcd')) # abcd라는 문자열의 각각의 문자 사이에 변수 s의 값인 ','를 삽입한다.- 소문자를 대문자로 바꾸기(upper)
s = "hi" print(s.upper())- 대문자를 소문자로 바꾸기(lower)
s = "HI" print(s.lower())- 왼쪽 공백 지우기(lstrip)
s = " hi" print(s.lstrip())- 오른쪽 공백 지우기(rstrip)
s = "hi " print(s.rstrip())- 양쪽 공백 지우기(strip)
s = " hi " print(s.strip())- 문자열 바꾸기(replace)
s = "Life is too short" print(s.replace("short", "long"))- 문자열 나누기(split)
s ="Life is too short"
print(s.split())    # 공백을 기준으로 나누고 리스트 형태로 리턴
print(s.split('is'))    # is를 기준으로 나누고 리스트 형태로 리턴
고급 문자열 포매팅
- 인덱스를 이용한 포매팅
print("{0}, {1}, {0}, {2}, {3}".format("first", "second", "third", "fourth"))- 이름을 이용한 포매팅
print("{first}, {second}, {fourth}, {second}".format(first=10, second=20, fourth=30))- 혼용한 포매팅
num = 1 var = 10 single = "solo" print("{0}, {var}, {string}".format(num, var=var, string=single))- 정렬
print("{0:<10}".format("hi")) # 치환되는 문자열을 왼쪽으로 정렬하고 문자열의 총 자리수를 10으로 맞춘다. print("{0:>10}".format("hi")) # 치환되는 문자열을 오른쪽으로 정렬하고 문자열의 총 자리수를 10으로 맞춘다. print("{0:^10}".format("hi")) # 치환되는 문자열을 중앙으로 정렬하고 문자열의 총 자리수를 10으로 맞춘다.- 공백 채우기
print("{0:=^10}".format("hi")) # 정렬을 실행한 뒤 공백을 '='문자로 채운다. print("{var:=^10}".format(var="hi")) # 정렬을 실행한 뒤 공백을 '='문자로 채운다.- 소수점 표현하기
print("{0:0.4f}".format(3.124123123)) # 소수점 아래 4자리까지만 표현한다. print("{0:10.4f}".format(3.124123123)) # 총 10자리를 주고 소수점 아래 4자리까지만 표현한다. print("{var:10.4f}".format(var=3.124123123)) # 총 10자리를 주고 소수점 아래 4자리까지만 표현한다.- ‘{’, ‘}‘문자 표현하기
print("{{ and }}") # 2회 반복하여 문자를 표현한다.
3. 리스트 자료형
- 리스트의 생성
a = []
b = [1, 2, 3]
c = ['Life', 'is', 'too', 'short']
d = [1, 2, 'Life', 'is']
e = [1, 2,['Life', 'is']]
- 리스트의 인덱싱과 슬라이싱
- 인덱싱
a = [1, 2, 3] print(a) # 리스트를 보여준다. print(a[0]) # 첫번째 인덱스에 들어있는 값을 보여준다. print(a[-1]) # 마지막 인덱스에 들어있는 값을 보여준다. - 슬라이싱
a = [1, 2, 3, 4, 5, 6]
print(a)        # 리스트를 보여준다.
print(a[0:4])   # 0 인덱스부터 3 인덱스까지 보여준다.(슬라이싱)
print(a[:4])    # 첫 인덱스부터 3 인덱스까지 보여준다.(슬라이싱)
print(a[2:5])   # 2 인덱스부터 4 인덱스까지 보여준다.(슬라이싱)
print(a[2:])    # 2 인덱스부터 마지막 인덱스까지 보여준다.(슬라이싱)
print(a[:])     # 모든 인덱스를 보여준다.(슬라이싱)
- 인덱싱
- 리스트 연산자
- 더하기 : 뒤에 붙여준다.(append)
- 곱하기 : 리스트를 반복한다.
- 리스트의 수정, 변경과 삭제
- 수정
a = [1, 2, 3] a[1] = 10 print(a) - 연속된 수정
a = [1, 2, 3, 4, 5] a[1:4] = ['a', 'b', 'c', 'd', 'e', 'f'] print(a) - [] 사용한 요소 삭제
a = [1, 2, 3, 4, 5, 6, 7, 8] print(a) a[5:6] = [] print(a) - del 함수를 사용한 요소 삭제
a = [1, 2, 3, 4, 5, 6, 7, 8]
print(a)
del a[1]
print(a)
del a[1:4]
print(a)
- 수정
- 리스트 관련 함수
- 리스트에 요소 추가(append)
a = [1, 2, 3] a.append(4) # 마지막에 붙여준다. - 리스트 정렬(sort)
a = [2, 3, 1, 0] a.sort() # 리스트 자체를 정렬한다. - 리스트 뒤집기(reverse)
a = [1, 2, 3] a.reverse() # 리스트 자체를 뒤집는다. - 위치 반환(index)
a = [1, 2, 3] print(a.index(2)) # 리스트에 2라는 값이 있으면 위치(인덱스)값을 리턴한다. print(a.index(0)) # 리스트에 0이라는 값이 있으면 위치(인덱스)값을 리턴한다. 0이라는 값이 존재하지 않기 때문에 오류를 발생시킨다. - 리스트에 요소 삽입(insert)
a = [1, 2, 3] a.insert(0, 4) # 0 인덱스 위치에 4를 삽입한다. 원래 0 인덱스는 1 인덱스가 된다. - 리스트 요소 제거(remove)
a = [1, 2, 3] a.remove(2) # 처음으로 나오는 2를 제거한다. - 리스트 요소 끄집어내기(pop)
a = [1, 2, 3] print(a.pop()) # 마지막 인덱스를 리턴하고 그 요소를 제거한다. - 리스트에 포함된 요소 x의 개수 세기(count)
a = [1, 2, 3, 1] print(a.count(1)) # 리스트에서 1의 개수를 리턴한다. - 리스트 확장(extend)
a = [1, 2, 3]
a.extend([4, 5])    # 매개 변수로 리스트만 올 수 있는 더하기 함수이다.
- 리스트에 요소 추가(append)
4. 튜플 자료형
- 몇 가지 특징을 제외하고는 리스트와 거의 비슷하다.
- 리스트는 ‘[‘과 ‘]‘으로 둘러싼다.
- 튜플은 ‘(‘과 ‘)‘으로 둘러싼다.
- 튜플의 요소값은 한 번 정하면 지우거나 변경할 수 없다.
- 생성
t1 = () # 빈 튜플 t2 = (1,) # 한개 튜플 t3 = (1, 2, 3) # 3개 튜플 t4 = 1, 2, 3 # 괄호 없이 선언한다면 튜플로 인식 t5 = ('a', 'b', ('ab', 'cd')) # 2차원 이상도 가능하다. - 튜플의 인덱싱과 슬라이싱, 더하기(+)와 곱하기(*)
- 인덱싱
t1 = (1, 2, 'a', 'b') print(t1[2])- 슬라이싱
t1 = (1, 2, 'a', 'b', 3, 4, 'c', 'd') print(t1[1:3]) # 1 인덱스부터 2 인덱스까지 print(t1[:3]) # 처음부터 2 인덱스까지 print(t1[3:6]) # 3 인덱스부터 5 인덱스까지 print(t1[3:]) # 3 인덱스부터 마지막까지- 튜플 더하기
t1 = (1, 2) t2 = (3, 4) print(t1 + t2) # 합쳐진 결과를 보여준다.- 튜플 곱하기
t1 = (1, 2)
print(t1 * 4)       # 반복한다.
5. 딕셔너리 자료형
대응 관계를 나타낼 수 있는 자료형으로 연관 배열(associative array) 또는 해시(Hash)라고 한다.
순차적으로 해상 요소값을 구하지 않고 Key를 통해 Value를 얻는다.
Key에는 변하지 않는 값을 사용하고, Value에는 변하는 값과 변하지 않는 값 모두 사용할 수 있다.
{Key1:Value1, Key2:Value2, Key3:Value3, ...}
dic1 = {'name':'pey', 'phone':'01033212232', 'birth':'1118'}
dic2 = {1:'a', 2:[1, 2, 3], 3:(4, 5, 6), ('a', 'b'):123123901294021, 'aaa':12312312}
딕셔너리 쌍 추가, 삭제하기
- 추가
dic = {1:'a'} dic[2] = 'b' # Key가 2이고 Value가 'b'인 딕셔너리 쌍을 a에 추가한다. dic[1] = 'c' # Key가 1인 쌍이 존재하므로 Value가 'c'로 변경된다.- 삭제
dic = {1:'a', 2:'c', 'hi':'bye'}
del dic['hi']       # key가 'hi'인 요소를 제거한다.
Key로 Value 접근
dic = {1:'a', 2:'c', 'hi':'bye'}
print(dic['hi'])
print(dic[1])
딕셔너리 생성시 주의사항
- Key는 고유한 값이므로 중복되는 Key 값을 설정해 놓으면 하나를 제외한 나머지 것들이 모두 무시된다는 점을 주의해야 한다.
- Key에 튜플은 가능하지만 리스트를 쓸 수 없다.(변할 수 있는 값)
딕셔너리 관련 함수
- Key 리스트 만들기(keys)
dic = {'name':'pey', 'phone':'01123234521', 'birth':'1232'} print(dic.keys()) # dict_keys 객체를 리턴한다. print(list(dic.keys())) # dict_keys 객체를 리스트로 변환하여 보여준다.- Value 리스트 만들기(values)
dic = {'name':'pey', 'phone':'01123234521', 'birth':'1232'} print(dic.values()) # dict_values 객체를 리턴한다. print(list(dic.values())) # dict_values 객체를 리스트로 변환하여 보여준다.- Key, Value 쌍 얻기(items)
dic = {'name':'pey', 'phone':'01123234521', 'birth':'1232'} print(dic.items()) # dict_items 객체를 리턴한다. print(list(dic.items())) # dict_items 객체를 리스트로 변환하여 보여준다.- Key:Value 쌍 모두 지우기(clear)
dic = {'name':'pey', 'phone':'01123234521', 'birth':'1232'} dic.clear() print(dic)- Key로 Value 얻기(get)
dic = {'name':'pey', 'phone':'01123234521', 'birth':'1232'} print(dic.get('name')) # Key가 있으면 Value 리턴 print(dic.get(1212312341512125)) # Key가 없으면 None을 리턴 print(dic[1012031230120310]) # Key가 없으면 오류!- 해당 Key가 딕셔너리 안에 있는지 조사하기(in)
dic = {'name':'pey', 'phone':'01123234521', 'birth':'1232'}
print('keys' in dic)    # Key가 없으면 False 리턴
print('name' in dic)    # Key가 있으면 True 리턴
6. 집합 자료형
- 집합(set)은 파이선 2.3부터 지원되기 시작한 자료형이다.
- 집합에 관련된 것을 쉽게 처리하기 위해 만들어졌다.
- 집합 자료형 특징
- 중복을 허용하지 않는다.
- 순서가 없다.(Unordered)
- set 자료형에 저장된 값을 인덱싱으로 접근하려면 리스트나 튜플로 변환하여 접근하여야 한다.
- 집합 자료형 생성
s1 = set("hello") print(s1) s2 = set([1, 2, 3]) print(s2) - 집합 자료형 활용
- 교집합, 합집합, 차집합 구하기
s1 = set([1, 2, 3]) s2 = set([3, 4, 5]) # 교집합 print(s1 & s2) print(s1.intersection(s2)) print(s2.intersection(s1)) # 합집합 print(s1 | s2) print(s1.union(s2)) print(s2.union(s1)) # 차집합 print(s1 - s2) print(s1.difference(s2)) print(s2 - s1) print(s2.difference(s1)) - 집합 자료형 관련 함수
- 값 1개 추가하기(add)
s1 = set([1, 2, 3]) s1.add(4) print(s1)- 값 여러 개 추가하기(update)
s1 = set([1, 2, 3]) s1.update([4, 5, 6]) print(s1)- 특정 값 제거하기(remove)
s1 = set([1, 2, 3])
s1.remove(2)
print(s1)
7. 자료형의 참과 거짓
자료형의 참과 거짓을 구분하는 기준
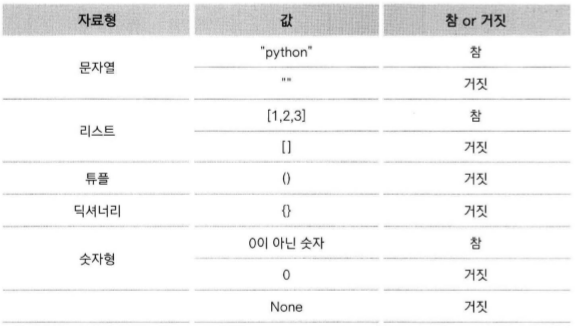
반복문과 조건문에서 조건식의 참과 거짓을 판단할 때 쓰인다.
8. 자료형의 값을 저장하는 공간, 변수
- 변수를 만들 때는 =(assignment)기호를 사용한다.
- 변수의 자료형을 쓸 필요가 없다.
- 변수에 저장된 값을 스스로 판단하여 자료형을 알아낸다.
- 변수란? 파이썬에서 사용되는 모든 것
- 파이썬에서 모든 리터럴은 객체이다.
- 메모리에 생성된 변수 없애기
del([변수명]) - 리스트를 변수에 넣고 복사하고자 할 때(객체지향의 특징)
- [:]를 이용한 복사
a = [1, 2, 3] b = a a[0] = 4 print(b) # b = a로 포인터만 준다면 a를 변경하면 b도 변경된다. a = [1, 2, 3] b = a[:] a[0] = 4 # b = a[:] 요소 각각을 복사한다면 a를 변경해도 print(b) # b는 변경되지 않는다.- copy 모듈을 이용한 복사
from copy import copy
a = [1, 2, 3]
b = copy(a)     # b = a[:]와 동일하다.
print(b is a)   # 같다면 True, 다르면 False